
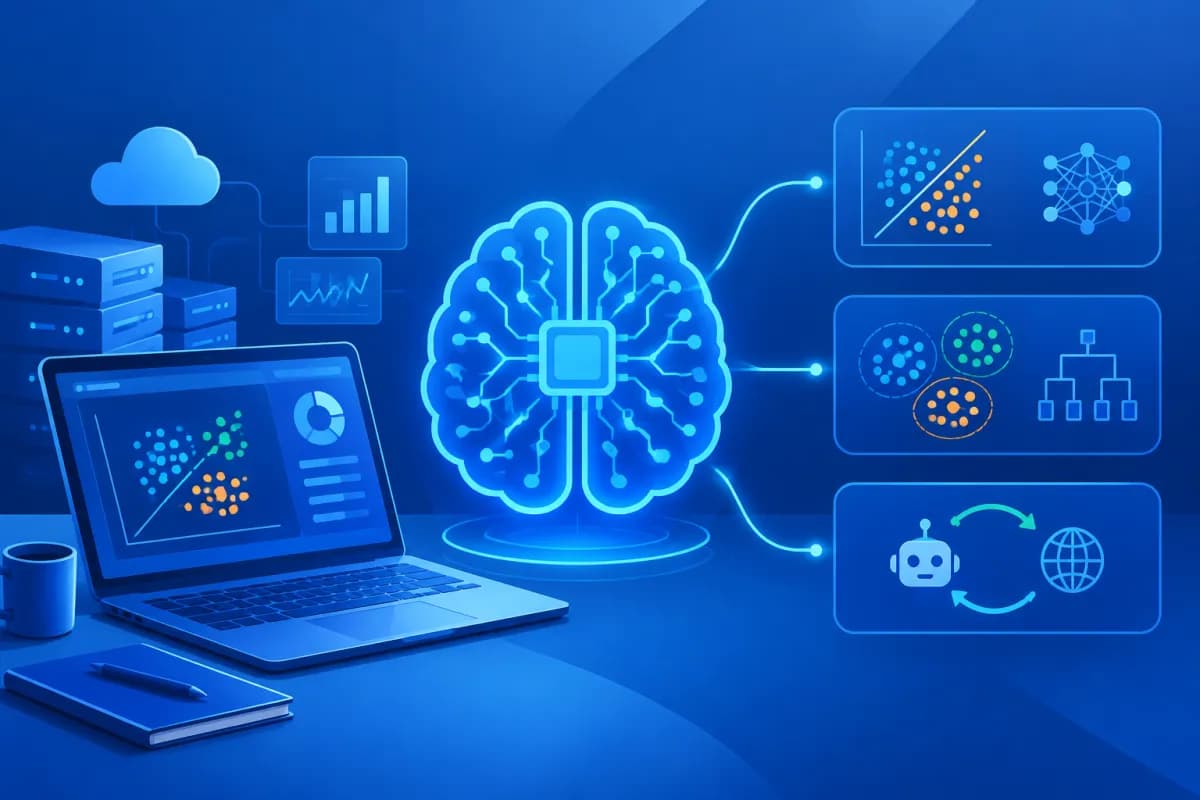
提到人工智能,很多人会想到聊天机器人、商品推荐系统或图像识别软件。这些应用背后,往往离不开机器学习——一种让计算机从数据中学习并进行预测或决策的技术。那么,机器学习是什么?三种最常见的方法又有哪些区别?
本文将用通俗易懂的语言解释这一概念,并结合常见场景对比监督学习、无监督学习和强化学习。通过这些内容,企业主和营销人员可以进一步了解如何将这项技术应用到实际工作中。
什么是机器学习?
机器学习是人工智能的一个分支。与其为每种情况预先编写规则,不如向计算机提供数据和学习方法,让它从中找出有用的规律。经过训练后,模型便能够预测结果,或对此前未接触过的新数据进行分类。
假设一家企业希望预测哪些客户更有可能购买。使用传统程序时,需要编写详细规则,例如:访问网站超过三次且已将商品加入购物车的访客,就被视为潜在客户。但购买行为往往比几条固定条件复杂得多。机器学习模型可以分析历史数据,包括访问次数、浏览内容、购买记录和营销活动反馈,从中找出通常与购买行为相关的信号。
基本流程通常包括三个步骤:
- 收集数据:整理相关信息,确保数据质量达标,并按照规定使用。
- 训练模型:利用数据让模型学习其中的关联或规律。
- 评估并应用:通过新数据检验模型的准确性,再将其用于实际流程并持续跟踪表现。
机器学习并不会像人一样自动理解所有事物。结果取决于目标、数据、训练方式以及企业如何使用模型。三种常见方法的主要区别,在于输入数据的类型以及系统接收反馈的方式。
监督学习:根据已有答案进行预测
监督学习使用已标注的数据训练模型,也就是说,每个样本都附有正确答案。模型通过对照输入信息和已知结果,学习如何为新情况预测答案。可以把它想象成学生参考标准答案做练习,并从中总结解题方法。
例如,银行掌握了一批已标记为正常或可疑的交易数据。模型会接收交易金额、时间、地点以及客户交易习惯等信息,并同时获得相应标签。学习之后,系统就能标记出可能存在欺诈迹象的新交易,供工作人员进一步核查。
在商业和营销领域,监督学习常用于:
- 潜在客户分类:根据历史数据预测客户转化可能性高或低。
- 营收预测:结合销售数据、季节性因素和营销活动,估算不同时间段的销售额。
- 情感分析:将评价或评论分类为正面、负面或中性。
- 风险识别:发现可能存在异常的交易、订单或档案。
这种方法的优势是目标明确;如果标注数据可靠,评估结果也相对容易。不过,企业需要准备足够多且分类准确的样本。如果标签有误、代表性不足,或反映了旧数据中的偏见,模型就可能学到这些偏差。准备数据有时比训练模型本身更耗时。
无监督学习:发现未知的群组和规律
与监督学习不同,无监督学习使用没有预先标注或附带答案的数据。模型会自行寻找数据之间的相似点、差异和潜在结构。系统不需要预测某个指定结果,而是要探索数据的组织方式。
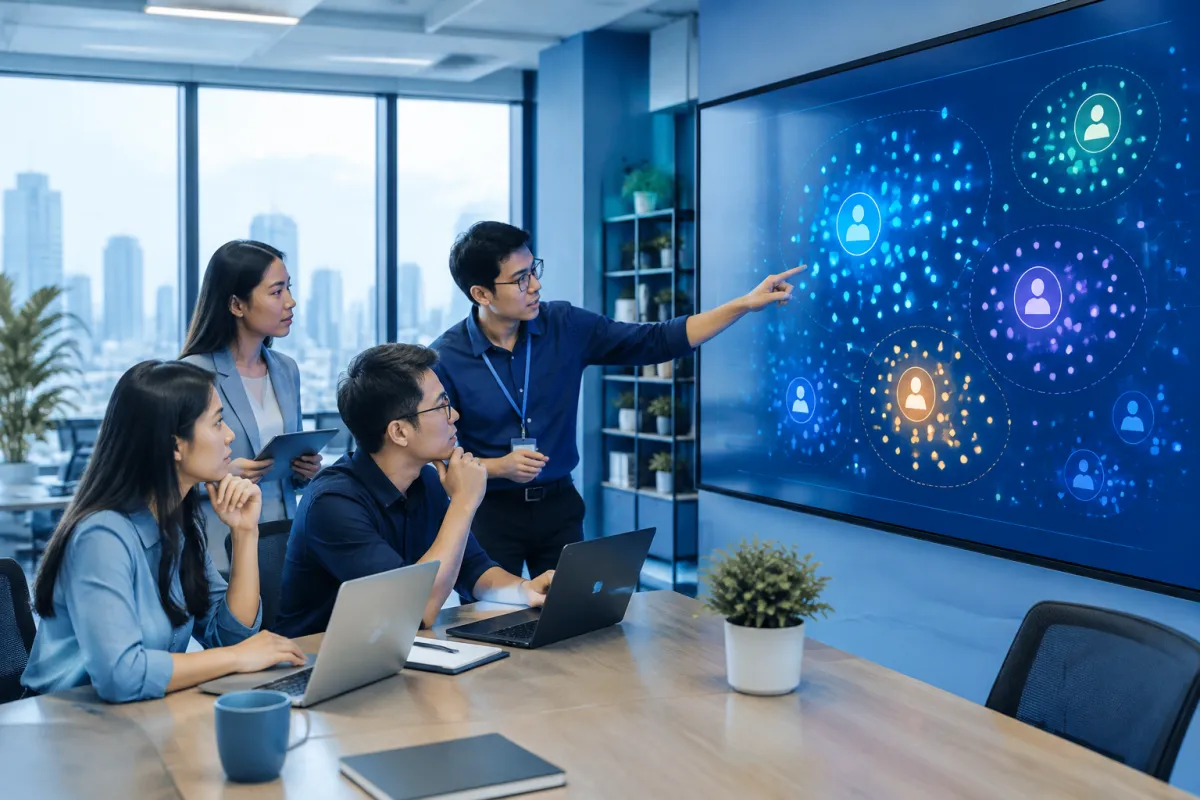
例如,一家网店掌握了大量客户信息,但尚未对客户进行分组。模型可以分析购买频率、订单金额、偏好商品类别和回访时间,识别出若干行为群组。结果可能显示:有的客户购买频繁但单笔金额较小,有的客户购买次数少但消费较高,还有的客户只在促销期间互动。营销人员可以据此设计更合适的营销信息和活动。
常见应用包括:
- 客户细分:在尚不清楚群组边界时,发现行为或需求相似的客户群体。
- 异常检测:识别与其他数据明显不同的情况,例如消费金额突然大幅上升。
- 主题发现:将含义相近的反馈或内容归类,找出客户经常提及的问题。
- 辅助数据探索:发现商品、行为或客户特征之间的关联,为分析提供线索。
无监督学习的优势在于能够利用企业中常见的海量未标注数据。但其结果未必只有一种解释。例如,模型把客户分成四组,并不意味着这四组自然对应四种有意义的客户画像。使用者需要结合业务知识进行审视、验证,并为各组确定名称。
强化学习:通过行动和反馈学习
强化学习是让智能体通过与环境互动来学习如何选择行动的一种方法。每次采取行动后,系统都会获得奖励或惩罚。其目标是找到能够长期最大化累计奖励的一系列行动。
可以把这个过程想象成训练一只狗:做出合适行为时给予奖励,不合适时不给奖励或加以提醒。经过多次尝试,智能体会逐渐调整选择。在强化学习中,反馈不一定会立即出现;某个决定可能要经过多个步骤之后,才能看出其影响。
一个容易理解的例子是仓储机器人需要在不碰撞障碍物的情况下前往取货地点。系统尝试不同路线,快速且安全抵达目的地时获得奖励,发生碰撞或绕远路时则被扣分。经过多轮交互,机器人会不断改进路线选择策略。
在企业中,强化学习可用于需要持续决策的问题,例如优化资源分配、控制机器人,或调整模拟环境中的运行策略。一些营销场景也可以通过建模来选择内容或优惠方案,但必须谨慎设计目标和安全边界,以免影响客户体验。
当系统能够与环境互动并获得结果反馈时,强化学习可能适用。不过,这种方法的训练通常较为复杂,需要大量尝试,也可能消耗较多资源。对于涉及客户、财务或安全的决策,如果尚未建立适当的监督机制和测试环境,不应让模型直接进行试验。
对比并选择合适的方法
三种方法都能让计算机从数据中学习,但适用于不同类型的问题。可以通过以下方式快速区分:
- 监督学习:数据有标签;适用于预测或分类已定义的结果。
- 无监督学习:数据没有标签;适用于发现群组、结构或异常点。
- 强化学习:系统通过行动和反馈学习;适用于在互动环境中优化一系列决策。
企业选择方法时,应从待解决的问题出发,而不是先关注技术名称。如果已经拥有带标签的历史数据,并希望预测客户流失率,监督学习可能是合适的选择。如果还不了解客户可以分成哪些群体,无监督学习或许能帮助发现线索。如果问题要求系统持续采取行动、观察结果并进行调整,则可以考虑强化学习。
在开始实施前,请明确业务目标和效果衡量方式;检查数据是否完整、准确且及时更新;同时考虑隐私、安全以及使用结果时应承担的责任。并非每个项目都需要机器学习。在很多情况下,清晰的业务规则或传统数据分析就能以更低成本解决问题。
优秀的模型不只是准确率高,还应能创造实际价值、便于管控,并与企业流程相匹配。
结语:从业务问题出发
什么是机器学习?它是让计算机从数据中学习规律,以进行预测、发现结构或选择行动的方法。监督学习使用带有答案的数据;无监督学习从未标注的数据中寻找结构;强化学习则通过互动和反馈不断改进决策。了解这些差异,有助于企业设定合理预期,并选择更符合自身需求的方法。
要有效应用机器学习,企业需要可靠的数据、明确的目标、合适的流程以及人工监督。LilyTech 为企业提供技术咨询、网站与应用设计、ERP 实施以及数字化转型解决方案。欢迎联系 LilyTech,获取符合企业目标和资源情况的实施建议。



