Khi nghe đến trí tuệ nhân tạo, nhiều người nghĩ ngay đến chatbot, hệ thống gợi ý sản phẩm hoặc phần mềm nhận diện hình ảnh. Đằng sau nhiều ứng dụng đó là machine learning, công nghệ giúp máy tính học từ dữ liệu để đưa ra dự đoán hoặc quyết định. Vậy machine learning là gì, và ba phương pháp phổ biến nhất khác nhau ra sao?
Bài viết dưới đây giải thích khái niệm bằng ngôn ngữ dễ hiểu, đồng thời so sánh học có giám sát, học không giám sát và học tăng cường qua những tình huống quen thuộc. Qua đó, chủ doanh nghiệp và người làm marketing có thể hình dung cách ứng dụng công nghệ này vào hoạt động thực tế.
Machine learning là gì?
Machine learning, hay học máy, là một nhánh của trí tuệ nhân tạo. Thay vì lập trình sẵn mọi quy tắc cho từng trường hợp, con người cung cấp dữ liệu và phương pháp học để máy tính tìm ra các mẫu có ích. Sau quá trình huấn luyện, mô hình có thể dự đoán kết quả hoặc phân loại dữ liệu mới mà trước đó chưa gặp.
Hãy hình dung doanh nghiệp muốn dự đoán khách hàng nào có khả năng mua hàng. Một chương trình thông thường cần được viết quy tắc chi tiết, chẳng hạn khách truy cập website trên ba lần và đã thêm sản phẩm vào giỏ thì được xem là khách tiềm năng. Nhưng hành vi mua hàng thường phức tạp hơn một vài điều kiện cố định. Mô hình học máy có thể phân tích dữ liệu lịch sử về lượt truy cập, nội dung đã xem, lịch sử mua và phản hồi chiến dịch để tìm ra những dấu hiệu thường đi kèm với việc mua hàng.
Quá trình cơ bản thường gồm ba bước:
- Thu thập dữ liệu: tập hợp thông tin liên quan, bảo đảm dữ liệu đủ chất lượng và được sử dụng đúng quy định.
- Huấn luyện mô hình: dùng dữ liệu để mô hình học mối liên hệ hoặc quy luật.
- Đánh giá và ứng dụng: kiểm tra độ chính xác trên dữ liệu mới, sau đó đưa mô hình vào quy trình thực tế và tiếp tục theo dõi.
Machine learning không tự động hiểu mọi thứ như con người. Kết quả phụ thuộc vào mục tiêu, dữ liệu, cách huấn luyện và cách doanh nghiệp sử dụng mô hình. Ba phương pháp phổ biến nhất khác nhau chủ yếu ở loại dữ liệu đầu vào và cách hệ thống nhận phản hồi.
Học có giám sát: dự đoán từ dữ liệu đã có đáp án
Học có giám sát là phương pháp huấn luyện mô hình bằng dữ liệu đã được gắn nhãn, tức mỗi ví dụ đi kèm với đáp án đúng. Mô hình đối chiếu thông tin đầu vào với kết quả đã biết để học cách dự đoán đáp án cho trường hợp mới. Có thể hình dung đây là việc học sinh làm bài tập có đáp án mẫu rồi rút ra cách giải.
Ví dụ, một ngân hàng có dữ liệu về các giao dịch đã được xác định là bình thường hoặc đáng ngờ. Mô hình được cung cấp thông tin như số tiền, thời gian, địa điểm và thói quen giao dịch của khách hàng, cùng nhãn tương ứng. Sau khi học, hệ thống có thể đánh dấu giao dịch mới có dấu hiệu gian lận để nhân viên kiểm tra.
Trong kinh doanh và marketing, học có giám sát thường được dùng cho:
- Phân loại khách hàng tiềm năng: dự đoán khách hàng có khả năng chuyển đổi cao hay thấp dựa trên dữ liệu lịch sử.
- Dự báo doanh thu: ước tính doanh số theo thời gian từ dữ liệu bán hàng, mùa vụ và hoạt động tiếp thị.
- Phân tích cảm xúc: phân loại đánh giá hoặc bình luận thành tích cực, tiêu cực hay trung tính.
- Phát hiện rủi ro: nhận diện giao dịch, đơn hàng hoặc hồ sơ có khả năng bất thường.
Ưu điểm của phương pháp này là kết quả có mục tiêu rõ ràng và dễ đánh giá nếu dữ liệu gắn nhãn đáng tin cậy. Tuy nhiên, doanh nghiệp cần có đủ ví dụ đã được phân loại đúng. Nếu nhãn sai, thiếu đại diện hoặc phản ánh định kiến trong dữ liệu cũ, mô hình có thể học theo sai lệch đó. Việc chuẩn bị dữ liệu đôi khi tốn nhiều thời gian hơn cả quá trình huấn luyện.
Học không giám sát: tìm nhóm và quy luật chưa biết trước
Khác với học có giám sát, học không giám sát sử dụng dữ liệu chưa có sẵn đáp án hoặc nhãn. Mô hình tự tìm điểm giống nhau, khác nhau và cấu trúc tiềm ẩn trong dữ liệu. Thay vì được yêu cầu dự đoán một kết quả cụ thể, hệ thống được giao nhiệm vụ khám phá cách dữ liệu được tổ chức.
Ví dụ, một cửa hàng trực tuyến có thông tin về nhiều khách hàng nhưng chưa chia họ thành nhóm. Mô hình có thể phân tích tần suất mua, giá trị đơn hàng, danh mục sản phẩm yêu thích và thời gian quay lại để nhận diện một số nhóm hành vi. Kết quả có thể cho thấy nhóm mua thường xuyên với đơn hàng nhỏ, nhóm mua ít nhưng chi tiêu cao, hoặc nhóm chỉ tương tác trong các đợt khuyến mãi. Nhân viên marketing có thể dùng những phát hiện này để thiết kế thông điệp và chương trình phù hợp hơn.
Một số ứng dụng tiêu biểu gồm:
- Phân khúc khách hàng: tìm các nhóm có hành vi hoặc nhu cầu tương tự khi chưa biết trước ranh giới giữa các nhóm.
- Phát hiện điểm bất thường: nhận diện dữ liệu khác biệt đáng kể so với phần còn lại, chẳng hạn mức chi tiêu tăng đột biến.
- Khám phá chủ đề: nhóm các phản hồi hoặc nội dung có ý nghĩa gần nhau để phát hiện vấn đề khách hàng thường nhắc đến.
- Gợi ý khám phá dữ liệu: tìm mối liên hệ giữa sản phẩm, hành vi hoặc đặc điểm khách hàng để hỗ trợ phân tích.
Điểm mạnh của học không giám sát là có thể khai thác kho dữ liệu chưa được gắn nhãn, vốn rất phổ biến ở doanh nghiệp. Nhưng kết quả không phải lúc nào cũng có cách diễn giải duy nhất. Chẳng hạn, mô hình chia khách hàng thành bốn nhóm không có nghĩa bốn nhóm đó tự nhiên đã tương ứng với bốn chân dung khách hàng có ý nghĩa. Người dùng cần xem xét, kiểm chứng và đặt tên nhóm dựa trên kiến thức kinh doanh.
Học tăng cường: học qua hành động và phản hồi
Học tăng cường là phương pháp trong đó một tác nhân học cách lựa chọn hành động thông qua tương tác với môi trường. Sau mỗi hành động, hệ thống nhận được phần thưởng hoặc hình phạt. Mục tiêu là tìm ra chuỗi hành động giúp tối đa hóa tổng phần thưởng trong dài hạn.
Có thể hình dung việc này giống như huấn luyện một chú chó: hành vi phù hợp được thưởng, hành vi không phù hợp không nhận thưởng hoặc bị nhắc nhở. Qua nhiều lần thử, tác nhân dần điều chỉnh lựa chọn. Trong học tăng cường, phản hồi không nhất thiết xuất hiện ngay lập tức; một quyết định có thể chỉ cho thấy tác động của nó sau nhiều bước.
Ví dụ dễ hiểu là robot kho hàng cần di chuyển đến vị trí lấy hàng mà không va chạm với chướng ngại vật. Hệ thống thử các hướng đi, nhận điểm thưởng khi đến đích nhanh và an toàn, hoặc bị trừ điểm khi va chạm hay đi đường vòng. Qua nhiều lượt tương tác, robot cải thiện chính sách lựa chọn đường đi.
Trong doanh nghiệp, phương pháp này có thể được xem xét cho các bài toán cần ra quyết định liên tục, như tối ưu hóa cách phân bổ nguồn lực, điều khiển robot hoặc điều chỉnh hoạt động trong một môi trường mô phỏng. Một số tình huống marketing cũng có thể mô hình hóa lựa chọn nội dung hay ưu đãi, nhưng cần thiết kế mục tiêu và giới hạn an toàn cẩn thận để tránh gây trải nghiệm không tốt cho khách hàng.
Học tăng cường phù hợp khi hệ thống có thể tương tác với môi trường và nhận phản hồi về kết quả. Đổi lại, việc huấn luyện thường phức tạp, cần nhiều lần thử và có thể tốn tài nguyên. Với những quyết định liên quan đến khách hàng, tài chính hoặc an toàn, không nên để mô hình tự thử nghiệm trực tiếp khi chưa có cơ chế giám sát và môi trường kiểm thử phù hợp.
So sánh và chọn phương pháp phù hợp
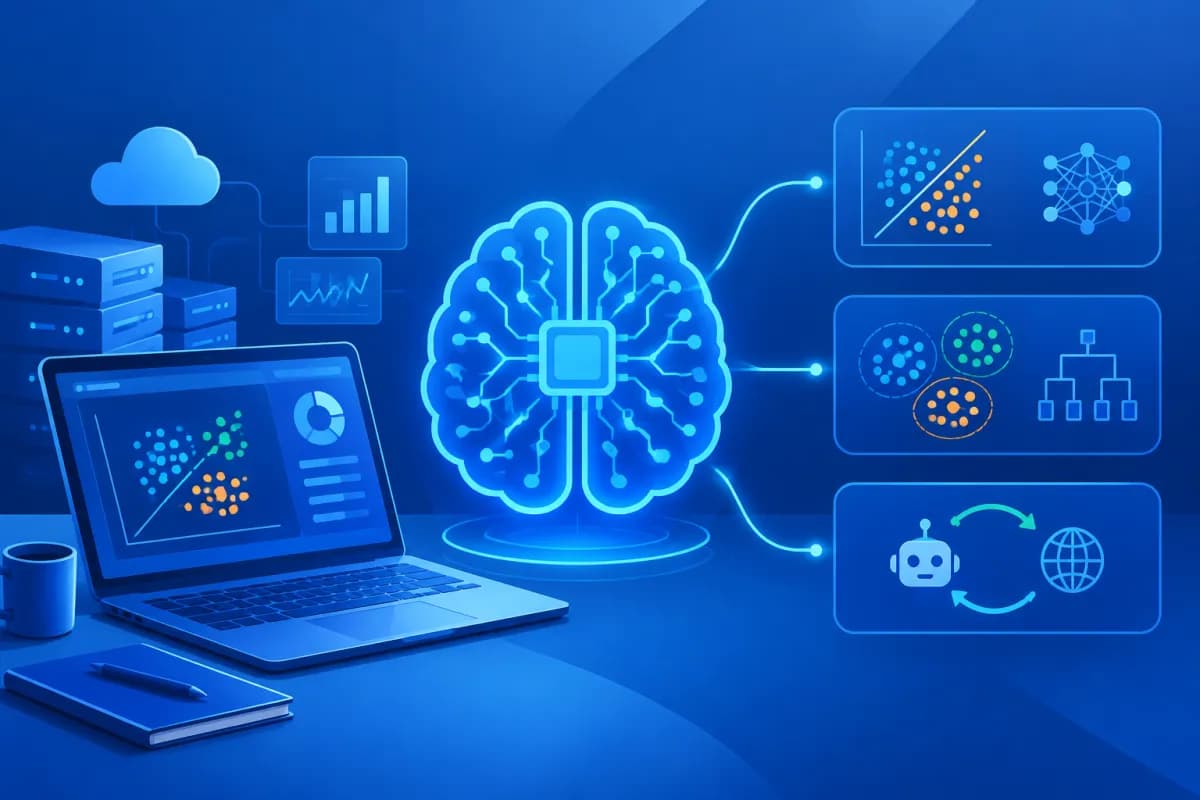
Ba phương pháp cùng giúp máy tính học từ dữ liệu, nhưng giải quyết những loại bài toán khác nhau. Có thể phân biệt nhanh như sau:
- Học có giám sát: dữ liệu có đáp án; phù hợp khi cần dự đoán hoặc phân loại một kết quả đã xác định.
- Học không giám sát: dữ liệu chưa có nhãn; phù hợp khi muốn khám phá nhóm, cấu trúc hoặc điểm bất thường.
- Học tăng cường: hệ thống học qua hành động và phản hồi; phù hợp khi cần tối ưu chuỗi quyết định trong môi trường tương tác.
Để chọn hướng tiếp cận, doanh nghiệp nên bắt đầu từ vấn đề cần giải quyết chứ không phải từ tên gọi công nghệ. Nếu đã có dữ liệu lịch sử được gắn nhãn và cần dự đoán tỷ lệ khách rời bỏ, học có giám sát có thể là lựa chọn phù hợp. Nếu chưa biết khách hàng chia thành những nhóm nào, học không giám sát có thể giúp khám phá. Nếu bài toán đòi hỏi hệ thống liên tục hành động, quan sát kết quả rồi điều chỉnh, học tăng cường có thể đáng cân nhắc.
Trước khi triển khai, hãy xác định rõ mục tiêu kinh doanh và cách đo hiệu quả; kiểm tra mức độ đầy đủ, chính xác và cập nhật của dữ liệu; đồng thời tính đến quyền riêng tư, bảo mật và trách nhiệm khi sử dụng kết quả. Không phải dự án nào cũng cần machine learning. Trong nhiều trường hợp, quy tắc nghiệp vụ rõ ràng hoặc phân tích dữ liệu truyền thống đã có thể giải quyết vấn đề với chi phí thấp hơn.
Mô hình tốt không chỉ là mô hình có độ chính xác cao. Mô hình cần tạo ra giá trị thực tế, có thể kiểm soát và phù hợp với quy trình của doanh nghiệp.
Kết luận: bắt đầu từ bài toán kinh doanh
Machine learning là gì? Đây là cách giúp máy tính học quy luật từ dữ liệu để dự đoán, khám phá cấu trúc hoặc lựa chọn hành động. Học có giám sát dùng dữ liệu có đáp án; học không giám sát tìm cấu trúc trong dữ liệu chưa gắn nhãn; còn học tăng cường cải thiện quyết định qua tương tác và phản hồi. Hiểu rõ khác biệt này giúp doanh nghiệp đặt đúng kỳ vọng và chọn cách tiếp cận sát với nhu cầu.
Để ứng dụng hiệu quả, doanh nghiệp cần kết hợp dữ liệu đáng tin cậy, mục tiêu rõ ràng, quy trình phù hợp và sự giám sát của con người. LilyTech đồng hành cùng doanh nghiệp trong tư vấn công nghệ, thiết kế website và ứng dụng, triển khai ERP và các giải pháp chuyển đổi số. Liên hệ LilyTech để được tư vấn hướng triển khai phù hợp với mục tiêu và nguồn lực của doanh nghiệp bạn.

