
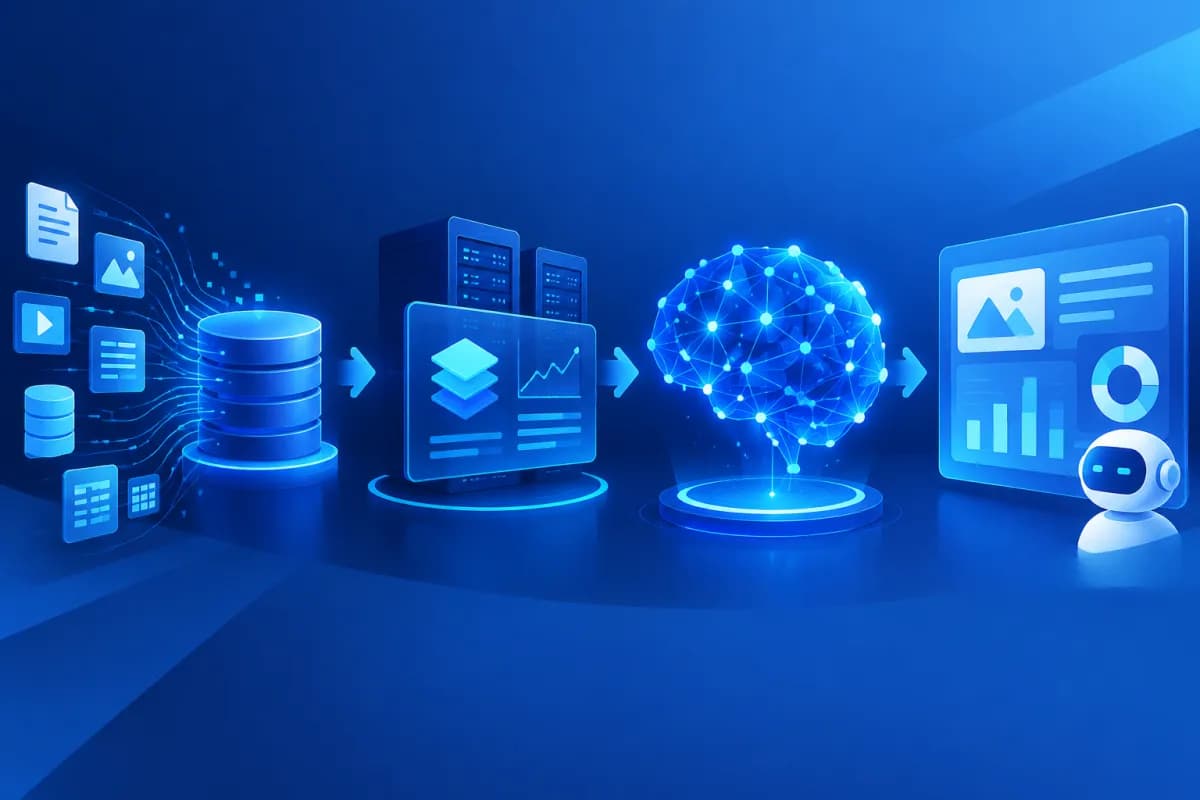
人工知能について調べる際、多くの企業がまず抱く疑問は、AIモデルとは何か、そして実務を支援できるモデルをどのように作るのか、ということです。簡単に言えば、AIモデルとは、データを使って学習し、パターンを認識したり、予測を行ったり、指示に応じてコンテンツを生成したりするシステムです。
モデルを効果的に機能させるには、アルゴリズムや最新技術を選ぶだけでは不十分です。課題の特定、データの準備、学習、評価、実環境への導入まで、一連のプロセスが必要です。本記事では各ステップを解説するとともに、企業が事前に管理すべきリスクも紹介します。
AIモデルとは何か、どのように動作するのか
AIモデルとは、コンピューターがデータから学習するプロセスを経て作られるものです。システムは学習の過程で関連性や繰り返し現れる特徴を見つけ、その知識を使って新しいデータを処理します。たとえば、請求書を認識するモデルは、何千枚もの請求書画像から学習し、金額、発行日、仕入先名を特定できます。
AIモデルとAIアプリケーションは区別して考える必要があります。モデルは予測や出力生成を担う要素であり、アプリケーションはユーザーが操作する完成した製品です。アプリケーションには、インターフェース、データベース、業務プロセス、AIモデルなどが含まれる場合があります。そのため、WebサイトやソフトウェアへのAI導入は、モデルを組み込むだけでは完結しません。データの送信方法、結果の表示方法、ユーザーによる確認方法も設計する必要があります。
モデルが担えるタスクは、カスタマーサポートへの問い合わせ分類、売上予測、画像認識、商品レコメンド、コンテンツの下書き生成など多岐にわたります。タスクごとに必要なデータ、評価方法、管理の度合いは異なります。企業は技術を先に選んで用途を探すのではなく、具体的な課題から始めるべきです。
AIモデルの構築・学習プロセス
1. 課題と成功基準を明確にする
データを収集する前に、モデルで何を解決するのか、誰が利用するのか、どのような結果が役立つのかを明確にします。たとえば、「営業にAIを活用する」という漠然とした目標ではなく、「30日以内に再購入する可能性が高い顧客層を予測する」といった課題を設定できます。
成功基準は、問い合わせ処理時間の短縮、分類精度の向上、業務プロセスのコスト削減など、事業活動に結び付けて設定します。同時に、システムの適用範囲と、従業員に対応を引き継ぐべきケースも定めます。こうすることで、技術的には優れた結果を出しても、実用的な価値につながらないモデルへの投資を避けられます。
2. データの収集・クリーニング・準備
データはモデルが学習するための基盤です。顧客管理ソフト、ERPシステム、Webサイト、アプリ、社内フォーム、適切な公開データなどから収集できます。利用する前に、データを扱う権限や利用目的、個人情報保護に関する義務を確認する必要があります。
生データには、欠損、重複、形式の誤り、不整合がよく見られます。たとえば、同じ注文ステータスが複数の表記で記録されていると、モデルが意味を認識しにくくなります。クリーニングでは通常、欠損値や重複レコードへの対処、形式の統一、異常データの確認を行います。テキストデータの場合は、ノイズとなる内容を除去したり、ラベルの付け方を統一したりする必要があります。
次に、特徴量を選択し、正解例を含むデータが必要な課題ではラベルを付与します。ラベルの品質は非常に重要です。担当者によるラベル付けの基準が統一されていないと、モデルが矛盾した判断を学習するおそれがあります。明確なラベル付けガイドラインを作成し、一部のデータを相互チェックするとともに、データセットの出所を記録することが大切です。
通常、データは学習用、調整用、テスト用のセットに分けます。テスト用データは、モデルが導入後に扱うデータを反映したものとし、開発中のモデル調整には使用しないようにします。同じ情報が複数のセットに含まれていると、評価結果が実態より高くなる可能性があります。
3. モデルを学習させる
学習では、アルゴリズムがデータを取り込み、設定した目標に沿って誤差を減らすようパラメーターを調整します。課題に応じて、従来型の機械学習モデル、ニューラルネットワーク、既存の生成AIモデルなどを選択できます。常に最大規模のモデルが最適とは限りません。コスト、速度、説明可能性、セキュリティ要件を考慮する必要があります。
学習は通常、管理された試行錯誤のプロセスです。担当者は設定を調整し、適切なデータセットで結果を確認しながら、モデルのバージョンやパラメーターを記録します。ゼロから学習させることと、事前学習済みモデルをファインチューニングすることは区別が必要です。多くの企業では、既存モデルを活用し、自社のデータや業務プロセスに合わせて調整することで時間を節約できます。ただし、利用権限や適合性は慎重に評価する必要があります。
4. 導入前に評価・テストする
学習後、モデルは学習に使用していないデータでテストします。評価指標は課題によって異なります。分類では、正解率、各グループを正しく識別する能力、見逃し率などを確認します。予測では、予測値と実際の値の差を測定できます。生成AIモデルでは、内容の適切さ、一貫性、誤情報の生成、指示への準拠状況を評価する必要があります。
単一の総合指標だけに頼るべきではありません。たとえば、正解率が高くても、発生頻度の低いリスク事例の大半を見逃すモデルもあり得ます。技術的なテストに加え、業務担当者に実際の状況を想定して結果を評価してもらい、例外的なケースを確認し、モデルの確信度が低い場合の対応を決める必要があります。効果とリスクの両方が許容範囲内にあることを確認してから導入しましょう。
モデルの導入・監視・改善
要件を満たしたら、モデルをアプリケーションや業務プロセスに接続します。導入先は、セキュリティ要件、技術力、予算に応じて、クラウド環境、専用サーバー、APIサービスなどから選択できます。データの受け取り方、アクセス権の認証、エラー処理、ユーザーへの結果返却方法を設計する必要があります。
最初から広範囲に適用するのではなく、限定的な試験運用から始めることもできます。たとえば、一部の従業員を支援する、または問い合わせの一部だけを処理する一方で、比較のために従来のプロセスも維持します。この方法なら、業務全体に影響が及ぶ前に問題を見つけられます。
導入後は、技術的な性能だけでなく、事業上の成果も監視する必要があります。季節、顧客行動、業務プロセスなどの変化によって実データが変わり、予測精度が徐々に低下することがあります。警告のしきい値を設定し、バージョンのログを保存し、ユーザーのフィードバックを記録したうえで、必要に応じてデータ更新や再学習を行う計画を立てましょう。顧客に大きな影響を及ぼす判断では、人による確認プロセスを維持することが望まれます。
AIモデル構築でよくあるリスク
- 偏りのあるデータ、または品質の低いデータ:利用状況を代表していないデータや、誤り・偏見を含むデータを使うと、モデルの精度が低下する可能性があります。学習前に、データの出所、網羅性、バランスを確認しましょう。
- 情報漏えい:アクセス権や保存ポリシーが不十分だと、顧客情報、従業員情報、企業秘密が不適切に利用されるおそれがあります。アクセス権を制限し、必要に応じてデータを匿名化するとともに、提供事業者の利用条件を確認してください。
- もっともらしく聞こえるが誤った結果:生成AIモデルは、誤った情報や根拠のない内容を出力することがあります。出力を事実と決めつけず、情報源を確認し、回答範囲を制限し、重要な内容は人が承認するようにしてください。
- 実態に即していない評価:テストで良い結果が出ても、広く導入した際に同じ効果が得られるとは限りません。実環境に近いデータ、例外的な状況、さまざまなユーザーグループを対象にテストしましょう。
- コストと技術への依存:規模の拡大に伴い、学習、サービス利用、保存、保守のコストが増加する可能性があります。投資前に、総保有コスト、提供事業者を切り替える可能性、長期的な運用計画を検討してください。
リスク管理は技術チームだけの仕事ではありません。営業、マーケティング、法務、情報システム、経営陣が、利用目的、責任者、インシデント対応プロセス、ユーザーにAIとのやり取りを知らせる方法について合意する必要があります。
まとめ
AIモデルとは何かを正しく理解することで、適切なデータや体系的な導入プロセスがなければ、AIが自動的に成果をもたらすわけではないと認識できます。課題の設定、データ準備、学習、評価、導入後の監視まで、各ステップがシステムの品質と安全性に影響します。
企業は具体的なニーズから始め、測定可能な成功基準を設定し、適切な範囲で試験運用してから展開するべきです。Webサイト、モバイルアプリ、ERP、マーケティング活動へのAI活用についてご相談が必要な場合は、LilyTechがニーズを分析し、最適な導入計画をご提案します。目標と実際のリソースに合わせたソリューションについて、LilyTechまでお問い合わせください。



