
 Nguyễn Chính Ngọc Liên
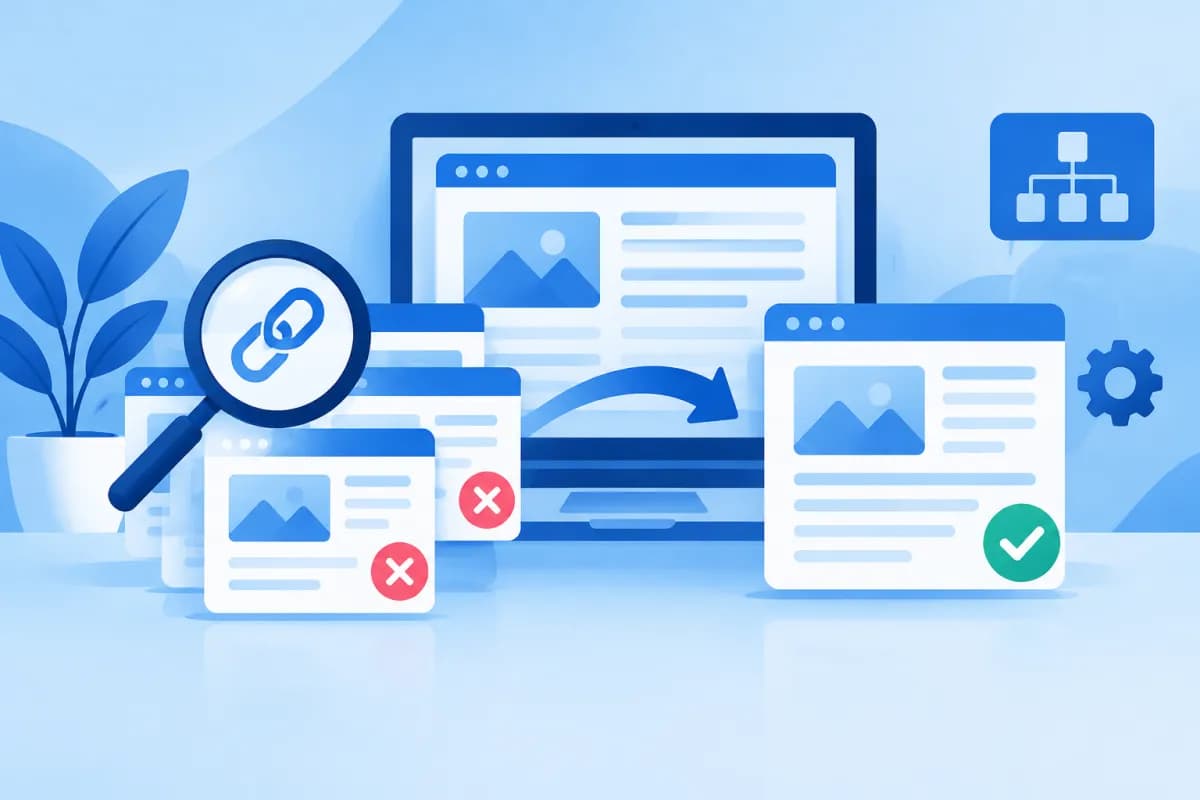
Xử lý nội dung trùng lặp là việc rà soát những trang có nội dung giống hoặc gần giống nhau, sau đó giúp công cụ tìm kiếm hiểu trang nào nên được ưu tiên. Tình trạng này có thể xuất hiện khi website có nhiều URL cho cùng một nội dung, khi sản phẩm có các trang gần như tương tự hoặc khi nội dung được đăng lại ở nhiều nơi.
Nội dung trùng lặp không đồng nghĩa website chắc chắn bị phạt, nhưng có thể khiến tín hiệu SEO bị phân tán, công cụ tìm kiếm thu thập dữ liệu kém hiệu quả và người dùng gặp nhiều trang na ná nhau. Bài viết dưới đây hướng dẫn cách phát hiện URL trùng lặp và lựa chọn giữa canonical, viết lại nội dung hoặc hợp nhất trang.
Nội dung trùng lặp là gì và vì sao cần xử lý?
Nội dung trùng lặp là nội dung giống hệt hoặc tương đồng đáng kể xuất hiện trên nhiều URL. Các URL này có thể cùng nằm trong một website hoặc thuộc những website khác nhau. Không phải mọi đoạn văn lặp lại đều là vấn đề: phần giới thiệu doanh nghiệp, thông tin liên hệ hay điều khoản có thể lặp tự nhiên. Điều cần quan tâm là nhiều URL cùng cạnh tranh để đại diện cho một chủ đề hoặc nhu cầu tìm kiếm.
Trùng lặp thường hình thành từ cấu trúc kỹ thuật hơn là chủ ý sao chép. Chẳng hạn, một trang có thể truy cập qua cả phiên bản có và không có www, qua HTTP và HTTPS, hoặc với dấu gạch chéo ở cuối URL và không có dấu gạch chéo. Bộ lọc sản phẩm, tham số theo dõi chiến dịch, phân trang và trang in cũng có thể tạo ra nhiều địa chỉ chứa nội dung gần giống nhau.
- Phân tán tín hiệu: liên kết nội bộ hoặc liên kết bên ngoài có thể trỏ tới nhiều URL thay vì tập trung vào trang doanh nghiệp muốn xếp hạng.
- Khó chọn trang ưu tiên: công cụ tìm kiếm có thể tự chọn URL đại diện khác với lựa chọn của chủ website.
- Lãng phí tài nguyên thu thập dữ liệu: bot có thể dành thời gian truy cập các biến thể URL thay vì những trang quan trọng hoặc mới.
- Trải nghiệm không nhất quán: người dùng có thể gặp nhiều trang tương tự, thông tin cũ hoặc nội dung không được cập nhật đồng bộ.
Vì vậy, mục tiêu không phải xóa mọi nội dung có điểm giống nhau. Mục tiêu là làm rõ quan hệ giữa các trang, giữ lại trang phù hợp với ý định tìm kiếm và xử lý các URL phụ theo cách nhất quán.
Cách phát hiện URL và nội dung trùng lặp
Hãy bắt đầu bằng việc lập danh sách URL thay vì chỉ tìm kiếm một vài câu văn giống nhau. Có thể dùng hệ thống quản trị nội dung, công cụ thu thập dữ liệu website hoặc báo cáo lập chỉ mục trong Google Search Console để nhận diện trang có tiêu đề, mô tả, nội dung chính hoặc canonical tương tự. Các công cụ hỗ trợ phát hiện vấn đề, nhưng cần kiểm tra thủ công trước khi thay đổi.
Rà soát các biến thể URL
Kiểm tra xem cùng một trang có thể truy cập qua nhiều phiên bản địa chỉ hay không: HTTP/HTTPS, www/không www, có/không có dấu gạch chéo cuối, chữ hoa/chữ thường và URL có tham số. Mở một số URL mẫu, xem phản hồi chuyển hướng và kiểm tra thẻ canonical trong mã nguồn. Nếu các phiên bản đều trả về nội dung độc lập, hãy xác định quy tắc chuẩn hóa phù hợp cho toàn website.
So sánh nội dung và mục đích tìm kiếm
Hai trang có thể khác vài câu nhưng vẫn phục vụ cùng một nhu cầu. Hãy so sánh chủ đề, đối tượng, sản phẩm hoặc dịch vụ được đề cập, nội dung chính và ý định tìm kiếm. Ví dụ, hai trang giới thiệu cùng một dịch vụ chỉ khác tên quận nhưng không có thông tin riêng hữu ích có thể là những trang gần trùng lặp. Ngược lại, hai trang cùng nói về một sản phẩm nhưng phục vụ nhóm người dùng hoặc tình huống sử dụng khác nhau có thể cần được giữ riêng.
Ghi lại từng nhóm URL trong bảng với các trường: URL, nội dung tương ứng, lượt truy cập hoặc chuyển đổi nếu có, liên kết nội bộ, trạng thái lập chỉ mục và hành động đề xuất. Bước này giúp tránh xóa nhầm trang đang có giá trị. Khi xử lý nội dung trùng lặp, quyết định nên dựa trên cả mục đích của trang lẫn dữ liệu thực tế, không chỉ dựa vào mức độ giống nhau của văn bản.
Chọn cách xử lý: canonical, viết lại hay hợp nhất?
Không có một giải pháp áp dụng cho mọi trường hợp. Hãy chọn cách xử lý theo mối quan hệ giữa các URL và giá trị riêng của từng trang. Canonical phù hợp khi cần giữ các phiên bản truy cập được nhưng muốn chỉ rõ URL đại diện. Viết lại phù hợp khi mỗi trang có thể đáp ứng một nhu cầu riêng nếu được bổ sung nội dung hữu ích. Hợp nhất phù hợp khi nhiều trang cùng phục vụ một mục đích và không cần tồn tại độc lập.
Dùng canonical khi các phiên bản cần cùng tồn tại
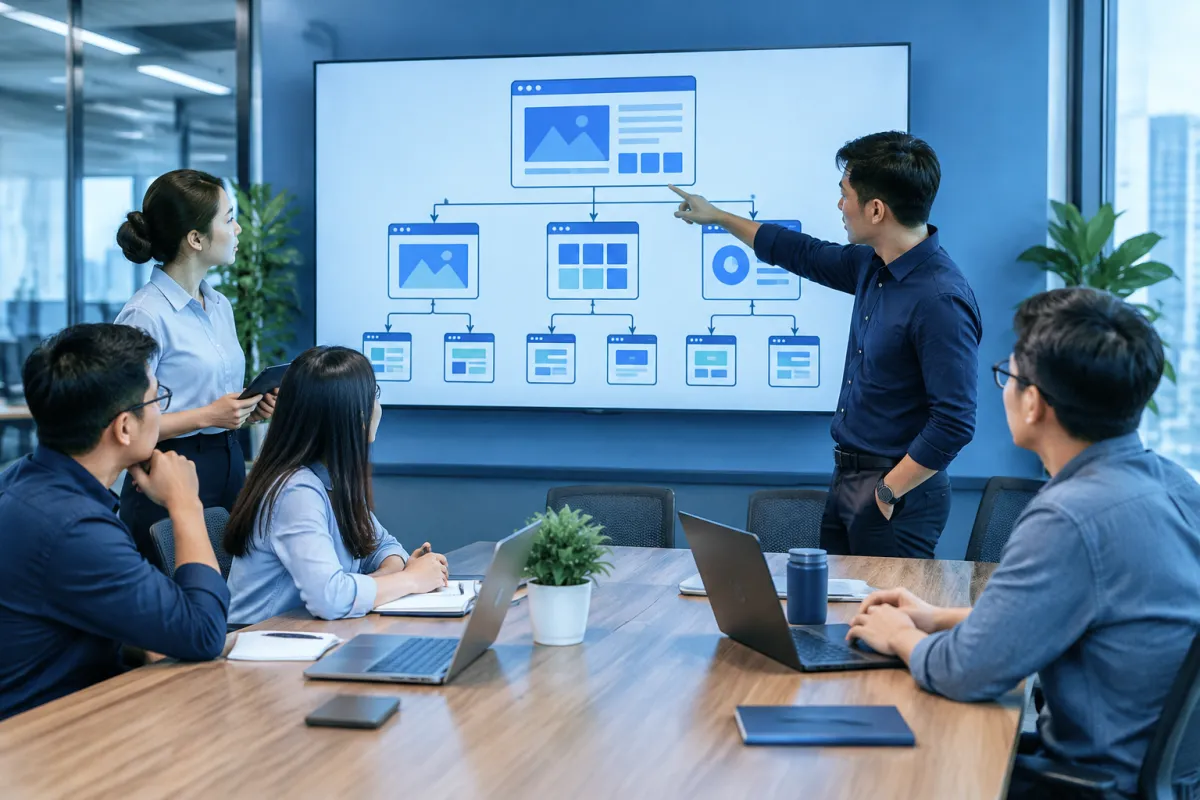
Thẻ canonical cho công cụ tìm kiếm biết URL nào là phiên bản ưu tiên trong một nhóm trang giống hoặc gần giống. Ví dụ, trang danh mục sản phẩm có bộ lọc màu tạo URL tham số; nếu trang lọc không có giá trị tìm kiếm độc lập, website có thể khai báo canonical trỏ về trang danh mục chuẩn. Canonical là tín hiệu ưu tiên, không phải chỉ thị tuyệt đối, vì vậy cần kết hợp với cấu trúc URL, liên kết nội bộ và sơ đồ website nhất quán.
Thông thường, trang chuẩn nên có canonical tự tham chiếu, còn các phiên bản phụ trỏ canonical về trang đó khi phù hợp. Tránh đặt canonical tới trang không liên quan, tới URL chuyển hướng hoặc tạo chuỗi canonical qua nhiều trang. Đồng thời, đừng chặn URL phụ bằng robots.txt nếu công cụ tìm kiếm cần truy cập để đọc tín hiệu canonical.
Viết lại khi mỗi trang có tiềm năng riêng
Nếu các trang nhắm đến những nhóm khách hàng, sản phẩm hoặc câu hỏi khác nhau, hãy làm rõ sự khác biệt thay vì gộp vội. Bổ sung thông tin độc đáo như tiêu chí lựa chọn, quy trình, tình huống áp dụng, câu hỏi thường gặp hoặc dữ liệu sản phẩm chính xác. Với trang địa phương, chỉ tạo nội dung riêng khi doanh nghiệp thực sự cung cấp thông tin hữu ích, chẳng hạn phạm vi dịch vụ hay quy trình phục vụ có căn cứ; không nên thay tên địa danh hàng loạt trong cùng một mẫu bài.
Hợp nhất khi nhiều trang cùng một mục đích
Khi một số bài viết hoặc trang dịch vụ chồng lấn chủ đề và không có lý do để duy trì riêng, hãy chọn trang đầy đủ, phù hợp nhất làm trang đích. Chuyển các phần thông tin hữu ích từ những trang còn lại vào trang này, sau đó chuyển hướng 301 các URL cũ tới URL mới nếu chúng đã bị loại bỏ. Cập nhật liên kết nội bộ, sitemap và các vị trí điều hướng để trỏ thẳng đến địa chỉ mới. Tránh chuyển hướng hàng loạt về trang chủ nếu nội dung đích không tương ứng.
Quy trình xử lý nội dung trùng lặp từng bước
Để hạn chế sai sót, hãy xử lý theo một quy trình có thể kiểm tra lại. LilyTech thường khuyến nghị doanh nghiệp phối hợp giữa người phụ trách nội dung, SEO và kỹ thuật web để quyết định vừa đúng mục đích kinh doanh vừa triển khai nhất quán trên website.
- Thu thập URL: xuất danh sách trang từ hệ thống quản trị nội dung, công cụ crawl và báo cáo lập chỉ mục. Gộp các URL theo nhóm nội dung hoặc mẫu tạo URL.
- Đánh giá giá trị: kiểm tra lượt truy cập, chuyển đổi, liên kết trỏ đến, mức độ cập nhật và vai trò của từng trang. Không xóa trang chỉ vì lưu lượng hiện tại thấp nếu trang có chức năng quan trọng.
- Xác định trang ưu tiên: chọn URL phù hợp nhất với chủ đề, ý định tìm kiếm và mục tiêu chuyển đổi. Nếu chưa có trang đáp ứng tốt, cân nhắc xây dựng hoặc cải thiện trang trước.
- Chọn phương án: giữ trang và đặt canonical, viết lại để phân biệt mục đích, hoặc hợp nhất và chuyển hướng. Ghi rõ lý do cho từng nhóm URL.
- Triển khai đồng bộ: cập nhật canonical, chuyển hướng, liên kết nội bộ, sitemap XML và các thẻ liên quan. Kiểm tra URL chuẩn dùng HTTPS và không tạo vòng lặp chuyển hướng.
- Kiểm tra sau triển khai: crawl lại website, thử truy cập URL cũ và mới, xác nhận mã phản hồi, canonical và khả năng lập chỉ mục. Theo dõi báo cáo trong Search Console để phát hiện bất thường.
Ví dụ, một cửa hàng có ba bài viết về cùng một dòng sản phẩm, mỗi bài chỉ khác cách diễn đạt và không đáp ứng mục đích riêng. Doanh nghiệp có thể chọn bài đầy đủ nhất, bổ sung thông tin đáng giá từ hai bài còn lại, rồi chuyển hướng các URL cũ đến bài hợp nhất. Nhưng nếu mỗi trang giới thiệu một phiên bản sản phẩm khác nhau với thông số và đối tượng sử dụng riêng, nên giữ các trang, viết nội dung đặc thù và tổ chức liên kết giữa chúng rõ ràng.
Checklist và lỗi cần tránh khi xử lý
Trước khi hoàn tất, hãy rà soát các điểm dưới đây. Một thay đổi đúng về nội dung vẫn có thể gây vấn đề nếu triển khai kỹ thuật thiếu nhất quán.
- Đã xác định chính xác URL nào là trang ưu tiên và lý do lựa chọn.
- Canonical trỏ đến URL hợp lệ, có nội dung tương ứng và không bị chuyển hướng.
- URL bị loại bỏ được chuyển hướng đến trang thay thế phù hợp, không tạo vòng lặp hoặc chuỗi dài.
- Liên kết nội bộ và sitemap không tiếp tục ưu tiên URL cũ hoặc URL phụ.
- Nội dung được viết lại thực sự có thông tin riêng, không chỉ thay từ đồng nghĩa hoặc đổi tên địa danh.
- Không dùng thẻ noindex, robots.txt và canonical theo cách mâu thuẫn nhau.
- Đã kiểm tra trải nghiệm người dùng trên thiết bị di động và các chức năng quan trọng sau khi cập nhật.
Một lỗi phổ biến là đặt canonical về trang chủ cho mọi URL không mong muốn. Cách này không giải thích đúng quan hệ nội dung và có thể bị bỏ qua. Lỗi khác là dùng chuyển hướng cho các trang vẫn cần truy cập độc lập, hoặc viết lại nội dung chỉ để tạo khác biệt hình thức. Hãy ưu tiên tính hữu ích và sự rõ ràng; tín hiệu kỹ thuật cần phản ánh đúng cấu trúc nội dung thay vì che giấu vấn đề.
Kết luận: xử lý đúng để củng cố cấu trúc SEO
Xử lý nội dung trùng lặp hiệu quả bắt đầu từ việc xác định nguyên nhân và phân biệt những URL chỉ là biến thể kỹ thuật với những trang có giá trị riêng. Dùng canonical khi cần chỉ định phiên bản ưu tiên, viết lại khi mỗi trang có thể phục vụ một nhu cầu khác nhau, và hợp nhất khi nhiều URL cùng mục đích. Sau khi triển khai, hãy kiểm tra chuyển hướng, liên kết nội bộ, sitemap và trạng thái lập chỉ mục để bảo đảm mọi tín hiệu thống nhất.
Nếu website có nhiều URL phát sinh từ bộ lọc, danh mục hoặc nội dung cũ, LilyTech có thể hỗ trợ rà soát cấu trúc và tư vấn phương án phù hợp với mục tiêu SEO, trải nghiệm người dùng và hoạt động kinh doanh. Liên hệ LilyTech để được trao đổi về tình trạng website và hướng xử lý khả thi.

