
 Đoàn Lê Minh Anh
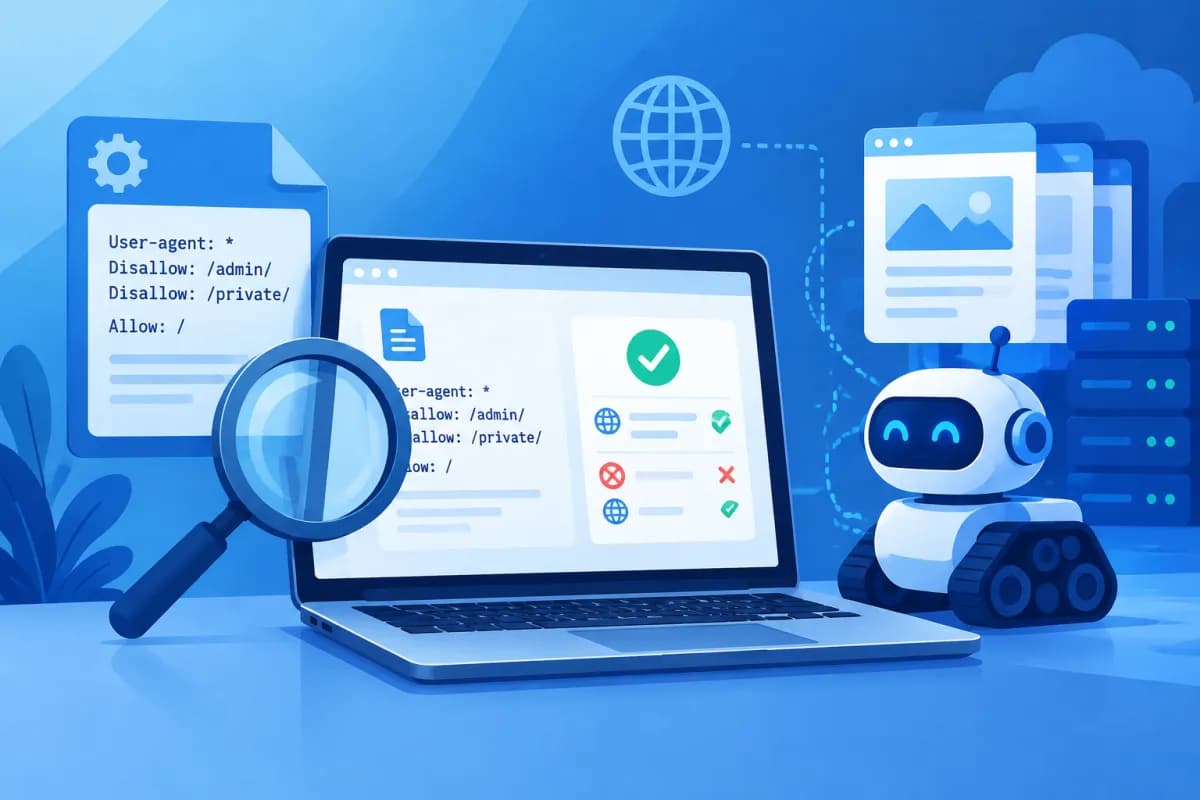
Robots.txt là một tệp nhỏ nhưng có thể ảnh hưởng lớn đến việc công cụ tìm kiếm thu thập dữ liệu website. Chỉ một quy tắc sai cũng có thể khiến Googlebot không truy cập được trang sản phẩm, bài viết hoặc tài nguyên cần thiết. Vì vậy, sử dụng công cụ kiểm tra robots.txt là bước quan trọng khi ra mắt website, thay đổi cấu trúc URL hoặc xử lý vấn đề SEO kỹ thuật.
Bài viết này giải thích các thành phần cơ bản của robots.txt, hướng dẫn kiểm tra URL bị chặn và tổng hợp những lỗi thường gặp. Qua đó, chủ doanh nghiệp và người làm marketing có thể đánh giá khả năng thu thập dữ liệu trước khi các giới hạn trong tệp ảnh hưởng đến khả năng hiển thị trên kết quả tìm kiếm.
Robots.txt là gì và ảnh hưởng thế nào đến SEO?
Robots.txt là tệp văn bản đặt tại thư mục gốc của một website, thường được truy cập qua địa chỉ như https://example.com/robots.txt. Tệp này đưa ra chỉ dẫn cho các trình thu thập dữ liệu, chẳng hạn Googlebot, về những khu vực chúng được phép hoặc không được phép yêu cầu truy cập. Mỗi tên miền, giao thức và tên miền phụ có thể cần một tệp robots.txt riêng.
Điều quan trọng là robots.txt chủ yếu điều tiết hoạt động thu thập dữ liệu, không phải cơ chế bảo mật hay công cụ bảo đảm một trang sẽ bị xóa khỏi kết quả tìm kiếm. Nếu URL bị chặn nhưng được liên kết từ nơi khác, công cụ tìm kiếm đôi khi vẫn biết URL đó tồn tại và có thể hiển thị thông tin hạn chế về trang. Nội dung riêng tư cần được bảo vệ bằng xác thực hoặc phân quyền truy cập phù hợp.
Quy tắc chặn cũng không đồng nghĩa trang chắc chắn mất khả năng xếp hạng, nhưng nó khiến bot khó đọc nội dung và tài nguyên của trang. Nếu Googlebot không tải được CSS hoặc JavaScript quan trọng, công cụ tìm kiếm có thể không hiểu đầy đủ cách trang hiển thị. Bởi vậy, cần kiểm tra cả URL nội dung lẫn các tài nguyên ảnh hưởng đến việc kết xuất trang.
Cú pháp robots.txt cơ bản cần nắm
Một quy tắc phổ biến gồm chỉ thị User-agent để xác định bot áp dụng và Disallow để khai báo đường dẫn không muốn bot thu thập. Chẳng hạn, User-agent: Googlebot áp dụng cho Googlebot, còn Disallow: /admin/ hướng dẫn bot không yêu cầu các URL nằm dưới đường dẫn đó. Dấu gạch chéo cuối có thể giúp quy tắc dễ đọc, nhưng cần hiểu rõ đường dẫn thực tế mà website sử dụng.
Ví dụ sau chặn thư mục tìm kiếm nội bộ với mọi bot, đồng thời khai báo vị trí sơ đồ website:
User-agent: * Disallow: /search/ Allow: /search/huong-dan/ Sitemap: https://example.com/sitemap.xmlTrong đó, dấu sao ở User-agent: * đại diện cho các trình thu thập dữ liệu không có nhóm chỉ thị riêng. Allow cho phép một đường dẫn cụ thể trong khu vực rộng hơn đang bị chặn. Khi các quy tắc chồng lấn, cách xử lý có thể phụ thuộc vào mức độ cụ thể của đường dẫn và quy ước của từng trình thu thập dữ liệu; vì vậy, không nên suy đoán kết quả chỉ bằng cách nhìn nhanh vào tệp.
Một số bot hỗ trợ ký tự đại diện như * để biểu thị chuỗi ký tự bất kỳ và ký hiệu $ để chỉ điểm kết thúc URL. Ví dụ, Disallow: /*?sort= có thể nhắm đến URL chứa tham số sắp xếp. Tuy nhiên, khả năng hỗ trợ và cách diễn giải không hoàn toàn giống nhau giữa mọi bot. Hãy kiểm tra tài liệu của công cụ tìm kiếm mục tiêu trước khi áp dụng quy tắc phức tạp.
Chỉ thị Sitemap thường ghi địa chỉ tuyệt đối của sitemap XML và có thể được đặt ở bất kỳ vị trí nào trong tệp. Sitemap giúp bot khám phá URL, nhưng không thể ghi đè quy tắc chặn. Nếu một trang quan trọng có trong sitemap nhưng bị Disallow, hai tín hiệu này không thay thế cho nhau; cần sửa lại cấu hình để bot có thể truy cập trang.
Cách dùng công cụ kiểm tra robots.txt để tìm URL bị chặn
Để kiểm tra có hệ thống, trước tiên xác định đúng phiên bản website cần đánh giá: http hay https, có www hay không, và đúng tên miền phụ. Sau đó, mở robots.txt tương ứng để xác nhận tệp có thể truy cập, nội dung mới nhất đã được triển khai và không xuất hiện lỗi tải trang. Tệp của example.com không tự động áp dụng cho shop.example.com.
- Chọn URL cần kiểm tra: Ưu tiên trang chủ, trang danh mục, sản phẩm, bài viết, trang lọc và những tài nguyên quan trọng. Ghi lại cả phiên bản URL có tham số nếu website tạo nhiều biến thể.
- Đọc nhóm quy tắc phù hợp: Tìm User-agent áp dụng cho bot đang xét, sau đó đối chiếu từng đường dẫn với Allow và Disallow. Đừng bỏ qua quy tắc chung User-agent: * khi không có nhóm cụ thể hơn.
- Dùng công cụ kiểm tra: Có thể sử dụng công cụ phân tích robots.txt để mô phỏng một bot truy cập URL, hoặc dùng chức năng kiểm tra URL trong Google Search Console để tìm thông tin thu thập dữ liệu và trạng thái lập chỉ mục. Giao diện, tên báo cáo và khả năng kiểm tra trực tiếp có thể thay đổi theo thời gian.
- Kiểm tra phản hồi thực tế: Truy cập URL bằng trình duyệt hoặc dùng công cụ dòng lệnh để xác minh trang trả về mã trạng thái phù hợp. Robots.txt chỉ cho biết chỉ dẫn đối với bot, không xác nhận trang có tồn tại, tải nhanh hay không yêu cầu đăng nhập.
- Thử lại sau khi sửa: Cập nhật tệp trên máy chủ, tải lại robots.txt và kiểm tra lại các URL quan trọng. Lưu ý bot có thể lưu bản sao tạm thời, nên thay đổi có thể không được phản ánh ngay trong mọi hệ thống.
Kết quả kiểm tra nên được đối chiếu với mục tiêu SEO, thay vì chỉ tập trung vào thông báo “được phép” hoặc “bị chặn”. Một URL có thể được phép thu thập nhưng vẫn không thể lập chỉ mục do thẻ noindex, mã trạng thái lỗi, nội dung trùng lặp hoặc vấn đề chất lượng. Ngược lại, URL bị chặn không thể được đánh giá đầy đủ về nội dung khi bot không truy cập được.
Các lỗi robots.txt thường gặp và cách khắc phục
Chặn toàn bộ website do cấu hình nhầm
Quy tắc Disallow: / trong nhóm User-agent: * có thể chặn mọi đường dẫn đối với các bot áp dụng nhóm đó. Tình huống này đôi khi xảy ra khi chuyển website từ môi trường thử nghiệm sang vận hành nhưng quên gỡ chỉ thị chặn. Hãy kiểm tra robots.txt sau mỗi lần triển khai lớn và xác nhận các trang cần SEO vẫn được phép thu thập.
Chặn nhầm thư mục hoặc tài nguyên quan trọng
Các quy tắc rộng như Disallow: /product có thể ảnh hưởng đến nhiều đường dẫn bắt đầu bằng chuỗi đó, không chỉ một trang cụ thể. Tương tự, chặn thư mục chứa CSS, JavaScript hoặc hình ảnh quan trọng có thể làm giảm khả năng kết xuất. Nên giới hạn phạm vi quy tắc, thử trên các URL đại diện và xác nhận cách bot nhìn thấy trang trước khi áp dụng toàn bộ.
Sai đường dẫn, ký tự hoặc vị trí tệp
Robots.txt cần nằm ở thư mục gốc của đúng host; đặt tệp trong một thư mục con thường không tạo ra chỉ dẫn toàn website. Lỗi viết hoa, dấu gạch chéo, đường dẫn tương đối hoặc quy tắc gắn nhầm vào User-agent cũng có thể làm kết quả khác dự kiến. Tên chỉ thị không phân biệt chữ hoa chữ thường theo quy ước thông dụng, nhưng nên viết thống nhất và giữ cú pháp đơn giản để dễ bảo trì.
Dùng robots.txt để xử lý nội dung không muốn lập chỉ mục
Nếu mục tiêu là yêu cầu công cụ tìm kiếm không lập chỉ mục một trang, chặn bot bằng robots.txt có thể phản tác dụng: bot không truy cập được để đọc chỉ thị noindex trên trang. Với nội dung được phép truy cập nhưng không muốn xuất hiện trên kết quả tìm kiếm, hãy cân nhắc phương án phù hợp như thẻ noindex hoặc tiêu đề HTTP tương ứng. Với nội dung nhạy cảm, cần dùng xác thực thay vì trông cậy vào robots.txt.
Quên kiểm tra sau khi cập nhật hệ thống
CMS, plugin SEO, đội ngũ phát triển hoặc nhà cung cấp dịch vụ có thể thay đổi tệp mà không được chú ý. Hãy lưu bản cấu hình đang hoạt động, phân quyền chỉnh sửa, kiểm tra robots.txt trong quy trình phát hành và định kỳ rà soát các URL quan trọng. LilyTech có thể hỗ trợ doanh nghiệp đánh giá cấu hình kỹ thuật, rà soát khả năng thu thập dữ liệu và kết nối các phát hiện với kế hoạch SEO tổng thể.
Quy trình duy trì khả năng thu thập dữ liệu ổn định
Thay vì chỉ kiểm tra khi website gặp sự cố, doanh nghiệp nên đưa robots.txt vào danh sách kiểm tra kỹ thuật định kỳ. Đặc biệt, cần đánh giá sau khi đổi tên miền, thiết kế lại website, chuyển nền tảng, tạo bộ lọc sản phẩm hoặc thay đổi cấu trúc thư mục. Những thay đổi này có thể tạo URL mới, làm quy tắc cũ quá rộng hoặc khiến các trang quan trọng bị bỏ sót.
- Lập danh sách các URL và nhóm trang cần bot truy cập, gồm trang danh mục, sản phẩm, nội dung chuyên môn và sitemap.
- Phân biệt trang cần chặn để tránh lãng phí thu thập với trang cần giữ khả năng hiển thị trên công cụ tìm kiếm.
- Kiểm tra cả URL mẫu và tài nguyên phụ thuộc; không suy rộng kết quả của một trang cho toàn bộ website.
- Kết hợp kiểm tra robots.txt với mã trạng thái HTTP, thẻ canonical, noindex, liên kết nội bộ và dữ liệu trong Search Console.
- Ghi lại lý do của từng quy tắc, người phê duyệt và thời điểm kiểm tra để thuận tiện khi khắc phục sự cố.
Với website thương mại điện tử hoặc nền tảng có nhiều bộ lọc, cần cân bằng giữa khả năng khám phá trang hữu ích và nguy cơ tạo quá nhiều URL biến thể. Không nên chặn hàng loạt chỉ vì thấy URL có tham số; một số tham số có thể đại diện cho nội dung quan trọng. Hãy dựa trên dữ liệu truy cập, cấu trúc liên kết và mục tiêu kinh doanh để xác định quy tắc cần thiết.
Kết luận: Kiểm tra robots.txt trước khi vấn đề ảnh hưởng SEO
Công cụ kiểm tra robots.txt giúp phát hiện nhanh quy tắc có thể ngăn bot truy cập URL, nhưng kết quả cần được xem trong bối cảnh tổng thể của website. Hiểu cú pháp User-agent, Disallow, Allow và Sitemap; kiểm tra đúng phiên bản tên miền; đồng thời đối chiếu với Search Console và phản hồi máy chủ sẽ giúp giảm rủi ro bỏ chặn nhầm trang quan trọng.
Nếu cần rà soát robots.txt, đánh giá khả năng thu thập dữ liệu hoặc xây dựng kế hoạch SEO kỹ thuật cho website, hãy liên hệ LilyTech để được tư vấn theo cấu trúc và mục tiêu kinh doanh của doanh nghiệp. Một quy trình kiểm tra rõ ràng giúp đội ngũ phát hiện sớm lỗi và duy trì nền tảng vững chắc cho tăng trưởng tìm kiếm tự nhiên.

